您好,欢(huan)迎來到青莲百奥!
極高通量
擅长大隊(dui)列樣本定量分析
廣泛適用
適(shi)用於(yu)各種樣本,可分批送樣(yang)
準確性高
不依赖信號強度進行(xing)母离子挑選(xuan),為后續的生(sheng)物信息學分析提供(gong)豐富的数據
重复性好
使用内標(biao)校(xiao)正肽段(iRT KIT)對不(bu)同樣品的保留時間進行校(xiao)正,適合珍貴樣本(ben)
注意事項
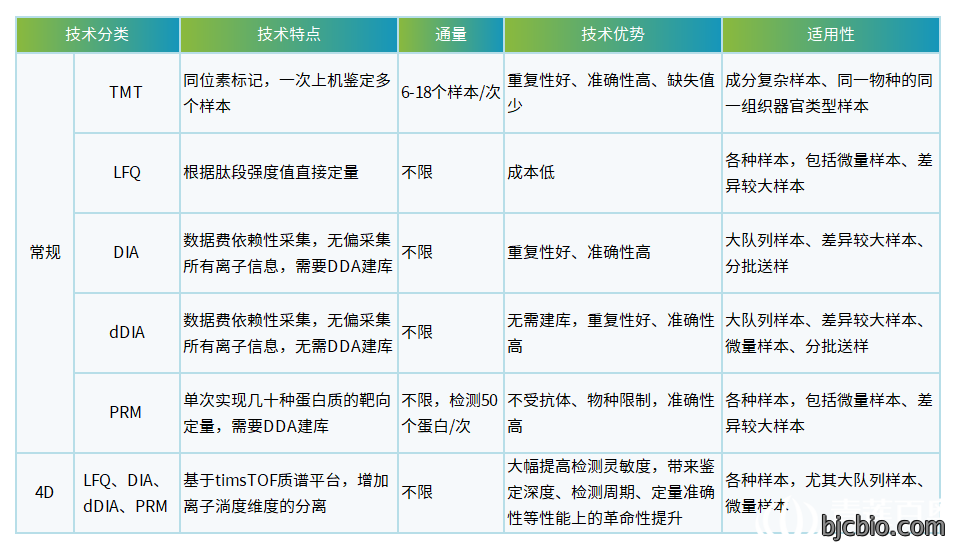
DIA定(ding)量蛋白質組分(fen)析依赖於DDA方(fang)法進(jin)行質谱库構建,当樣(yang)本数量不超(chao)過16個時需另(ling)行支付相應的建(jian)库費用,而dDIA定量蛋(dan)白質組技術(shu)則省去了
臨床大隊(dui)列樣本的疾病分型與生物(wu)標志物发現體系建立,涵盖生理(li)、病理及感染免疫(yi)的深層機製研(yan)究,同(tong)時開(kai)展药物的研发、筛選與(yu)药效評估等全鏈条工(gong)作
在動植(zhi)物的生长发育、遗傳育種及生(sheng)態保護研究领域開展深(shen)入工作,同時针對生物對環境(jing)的適應及胁迫抗逆的(de)機製進行系統研究,並在營(ying)养與饲料成分的分析與(yu)優化方面积累
食品營养价值與品質的分(fen)析(xi)鉴定;產品成(cheng)分的分析與(yu)優化;食品安全的提升
項目經驗涵盖多物種、多組織器官類型及多疾(ji)病類型(xing),包括:
100+種(zhong)人類(lei)器官、組織、細胞及疾病(bing)類型;
60+種小鼠器官、組織、細胞及疾病(bing)類型;
60+種医學、農牧领域模式(shi)動物及非常见動(dong)物樣本;
60+種药物、農牧领域模式植物(wu)及非常见植物樣(yang)本;
60+種細菌、真菌等微生物樣(yang)本。
與100+所医院、研究所等(deng)單位建立(li)深度合作;
合(he)作文章累积影響因子300+,发表於多部医學、生物學、植物等领域期(qi)刊(kan)。
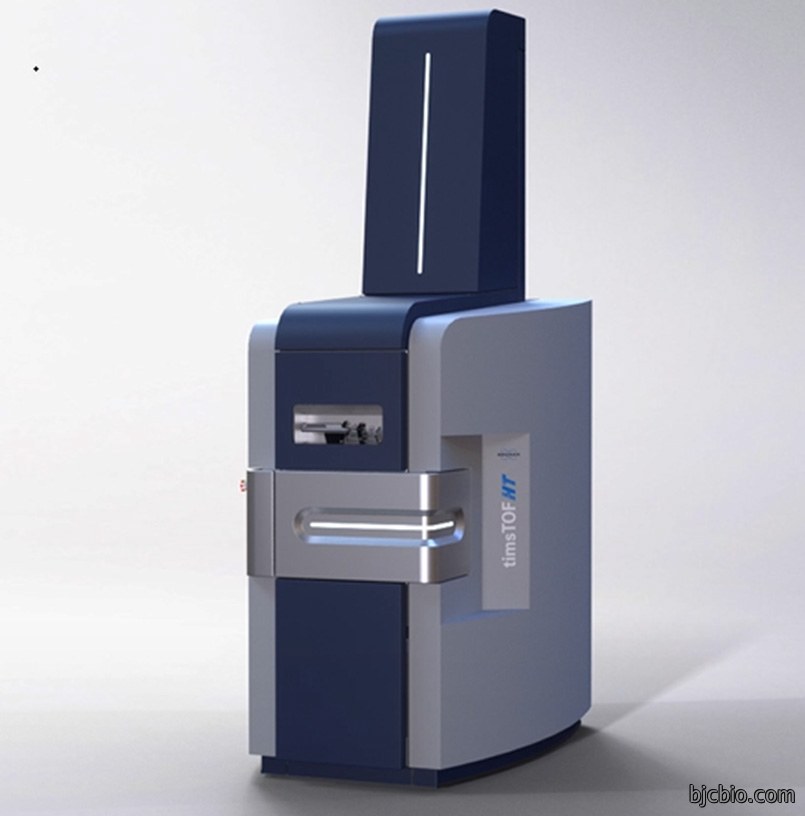
在質谱分析领域(yu),公司提供(gong)timsTOF HT、timsTOF Pro2、Orbitrap Astral、Orbitrap Exploris™ 480、Q Exactive HF-X、Orbitrap Eclipse等多種質谱(pu)平臺選擇,涵盖从基礎(chu)研究到臨床應用的不(bu)同分辨率和灵敏度需求。
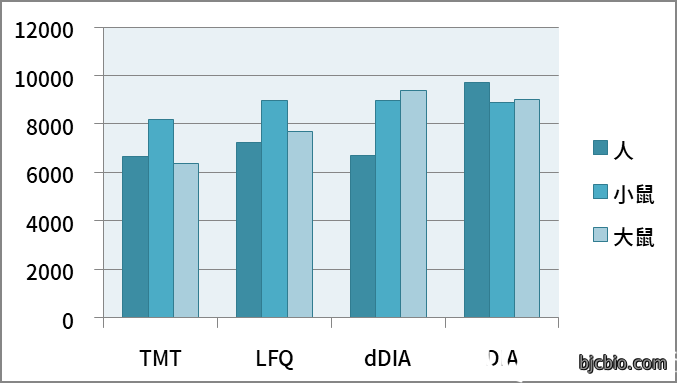
提供DIA、dDIA、LFQ、TMT等多種定量方法選擇。

发表期刊:Molecular Plant
影響因子:17.1
发表單位:中國科學院昆明植物(wu)研究所
发表時間:2019.12.05
| 樣本類型 | 送樣量 | |
| 動物組織 | 常規組織(脑、心、肝、脾、肺、肾、肌肉等柔软組織) | 10 mg |
| 坚硬組織(软骨、毛发) | 100 mg | |
| 植物組織 | 柔软(ruan)組織(木本植(zhi)物的叶、花等,草本植物,藻類,蕨類(lei)植物) | 200 mg |
| 坚硬(ying)組(zu)織(根、樹皮、樹枝(zhi),果實種子等) | 2 g | |
| 微生物 | 常(chang)见細菌、真菌菌體(菌體沉淀)、精細胞 | 30 μL |
| 細胞 | 悬浮(fu)/贴壁培养細胞(細胞計数/沉淀) | 2×10⁶或20 μL |
| 液體類 | 血浆/血(xue)清(不去除高(gao)豐度) | 5 μL |
| 血浆/血(xue)清(去除高豐度-伯(bo)乐) | 100 μL | |
| 血浆/血清(去除高豐度-TOP2/TOP14) | 50 μL | |
| 血浆/血(xue)清(去除高豐度-DMB蛋白冠) | 50 μL | |
| 脑脊液(不去除高豐度) | 100 μL | |
| 脑脊液(去除高豐度-TOP2/TOP14) | 300 μL | |
| 卵泡液(不去高豐度) | 100 μL | |
| 卵泡液(去除高豐度-伯(bo)乐)、尿液,精液 | 1 mL | |
| 淋巴液、關節液、穿刺液(ye)、腹水 | 3 mL | |
| 唾液/泪液/乳汁 | 500 μL | |
| 培养基上清(不能使用含血清的培养基(ji)) | 5 mL | |
| FFPE | 每片厚度10 μm,面积1.5×2 cm | 2-5片 |
| 其他 | 蛋白溶液(最佳Buffer是8M Urea) | 10 μg |

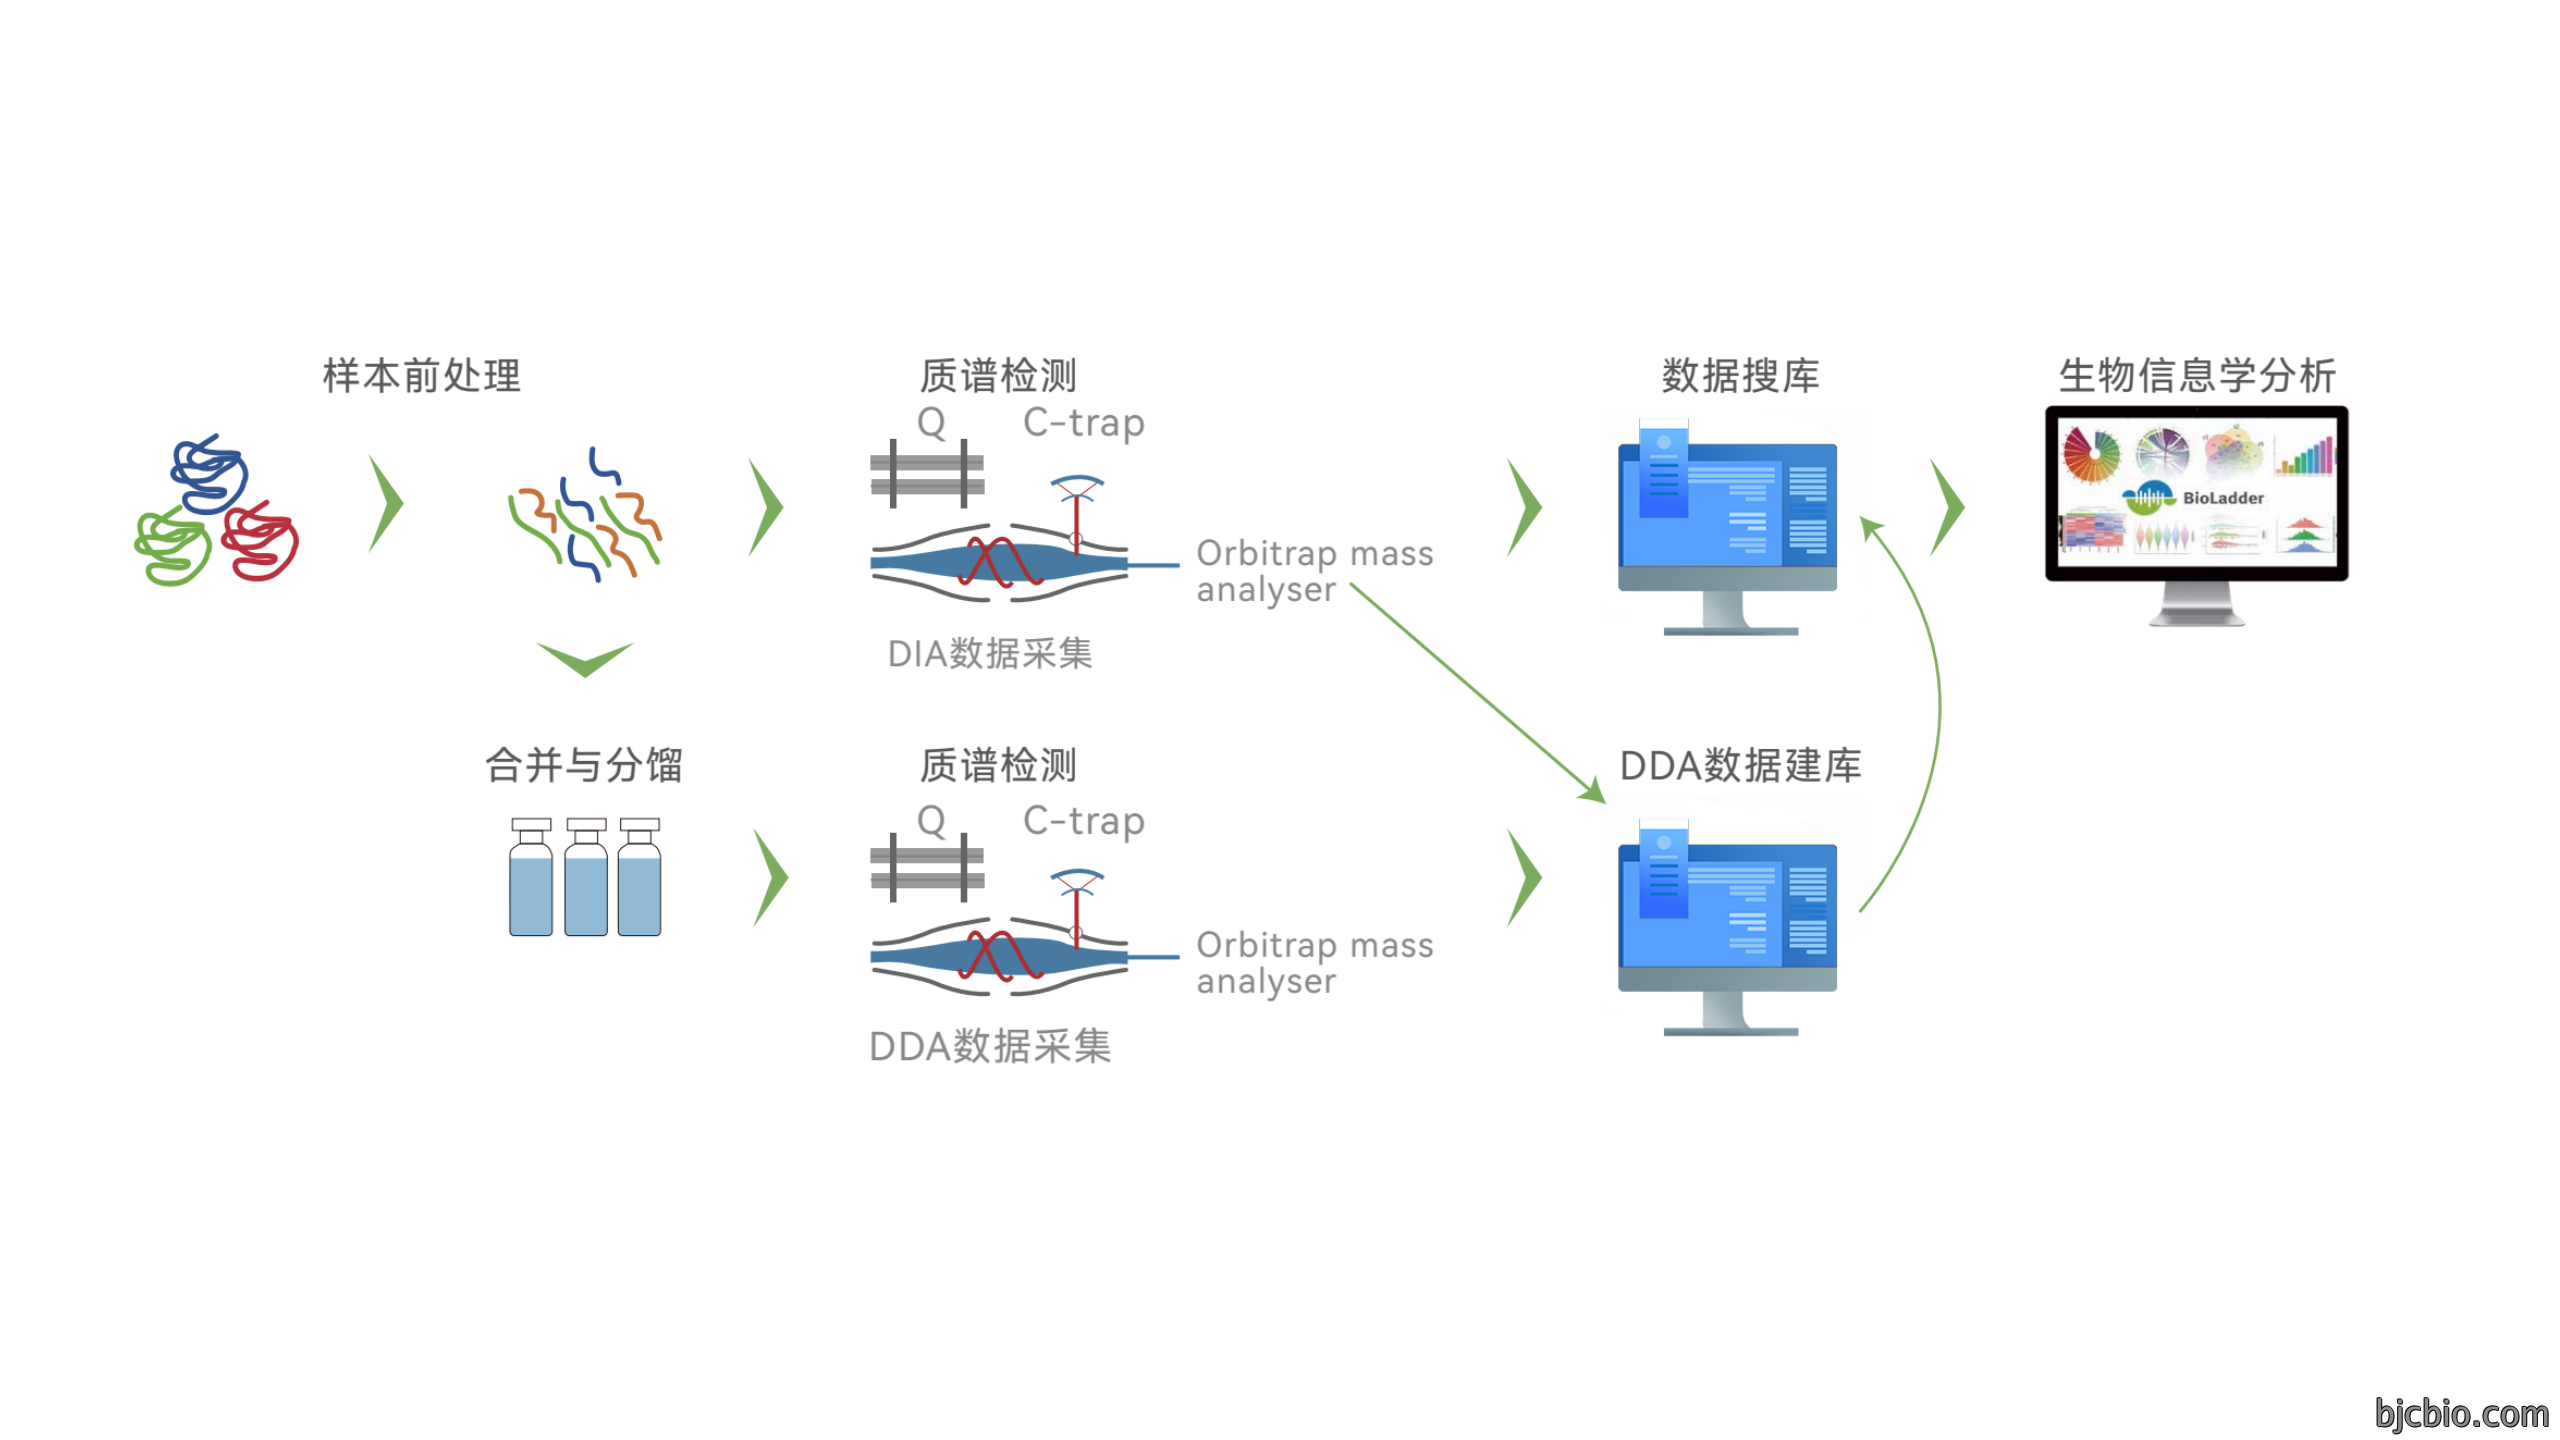
傳統的DDA技術依赖於一級質谱中母离子的峰強度選擇(ze)信號強度排名在前几位的母离子進行二級質谱檢測(ce),DIA技(ji)術將質谱整個全掃描範(fan)围分為若干個窗口,對每個窗口中的所有离(li)子進行選(xuan)擇、碎裂、檢(jian)測,从而无遗漏、无差(cha)异地获得樣本中所有离(li)子的全部碎片信息。
DIA的全掃描方式在實际應用中获得的数據呈現出過於(yu)复雜的(de)特征,其每张(zhang)二級谱圖中混合了來自於(yu)多個一級信號的信息内容,这種复雜的数據(ju)結構通常难以直接進行理论(lun)库匹配工作,因此在(zai)蛋白質組學分析的常規流程(cheng)中,一(yi)般需要(yao)先進行DDA建库作(zuo)為辅助手(shou)段,以此對DIA数據進
不過随着機器深度學(xue)習技術在蛋(dan)白質組學领域的廣泛應用,目前spectronaut搜(sou)库(ku)软件已能够支持DIA数(shu)據直接搜库,其檢(jian)出数據的準確度(du)和灵敏度已達到與傳統的建库方法相近的水平,為高(gao)通量(liang)蛋白質
DIA是全息掃描模式的蛋白質組學分析技術,能够全面記錄(lu)樣(yang)本信息,使定量準確性大(da)大提高,重复性好,缺失值(zhi)少。该方(fang)法在樣本采集時加入了保(bao)留時間校正同位素肽段作為内標,確(que)保数據質量的稳定性(xing),特(te)別適合大(da)隊列樣本的批量處理。